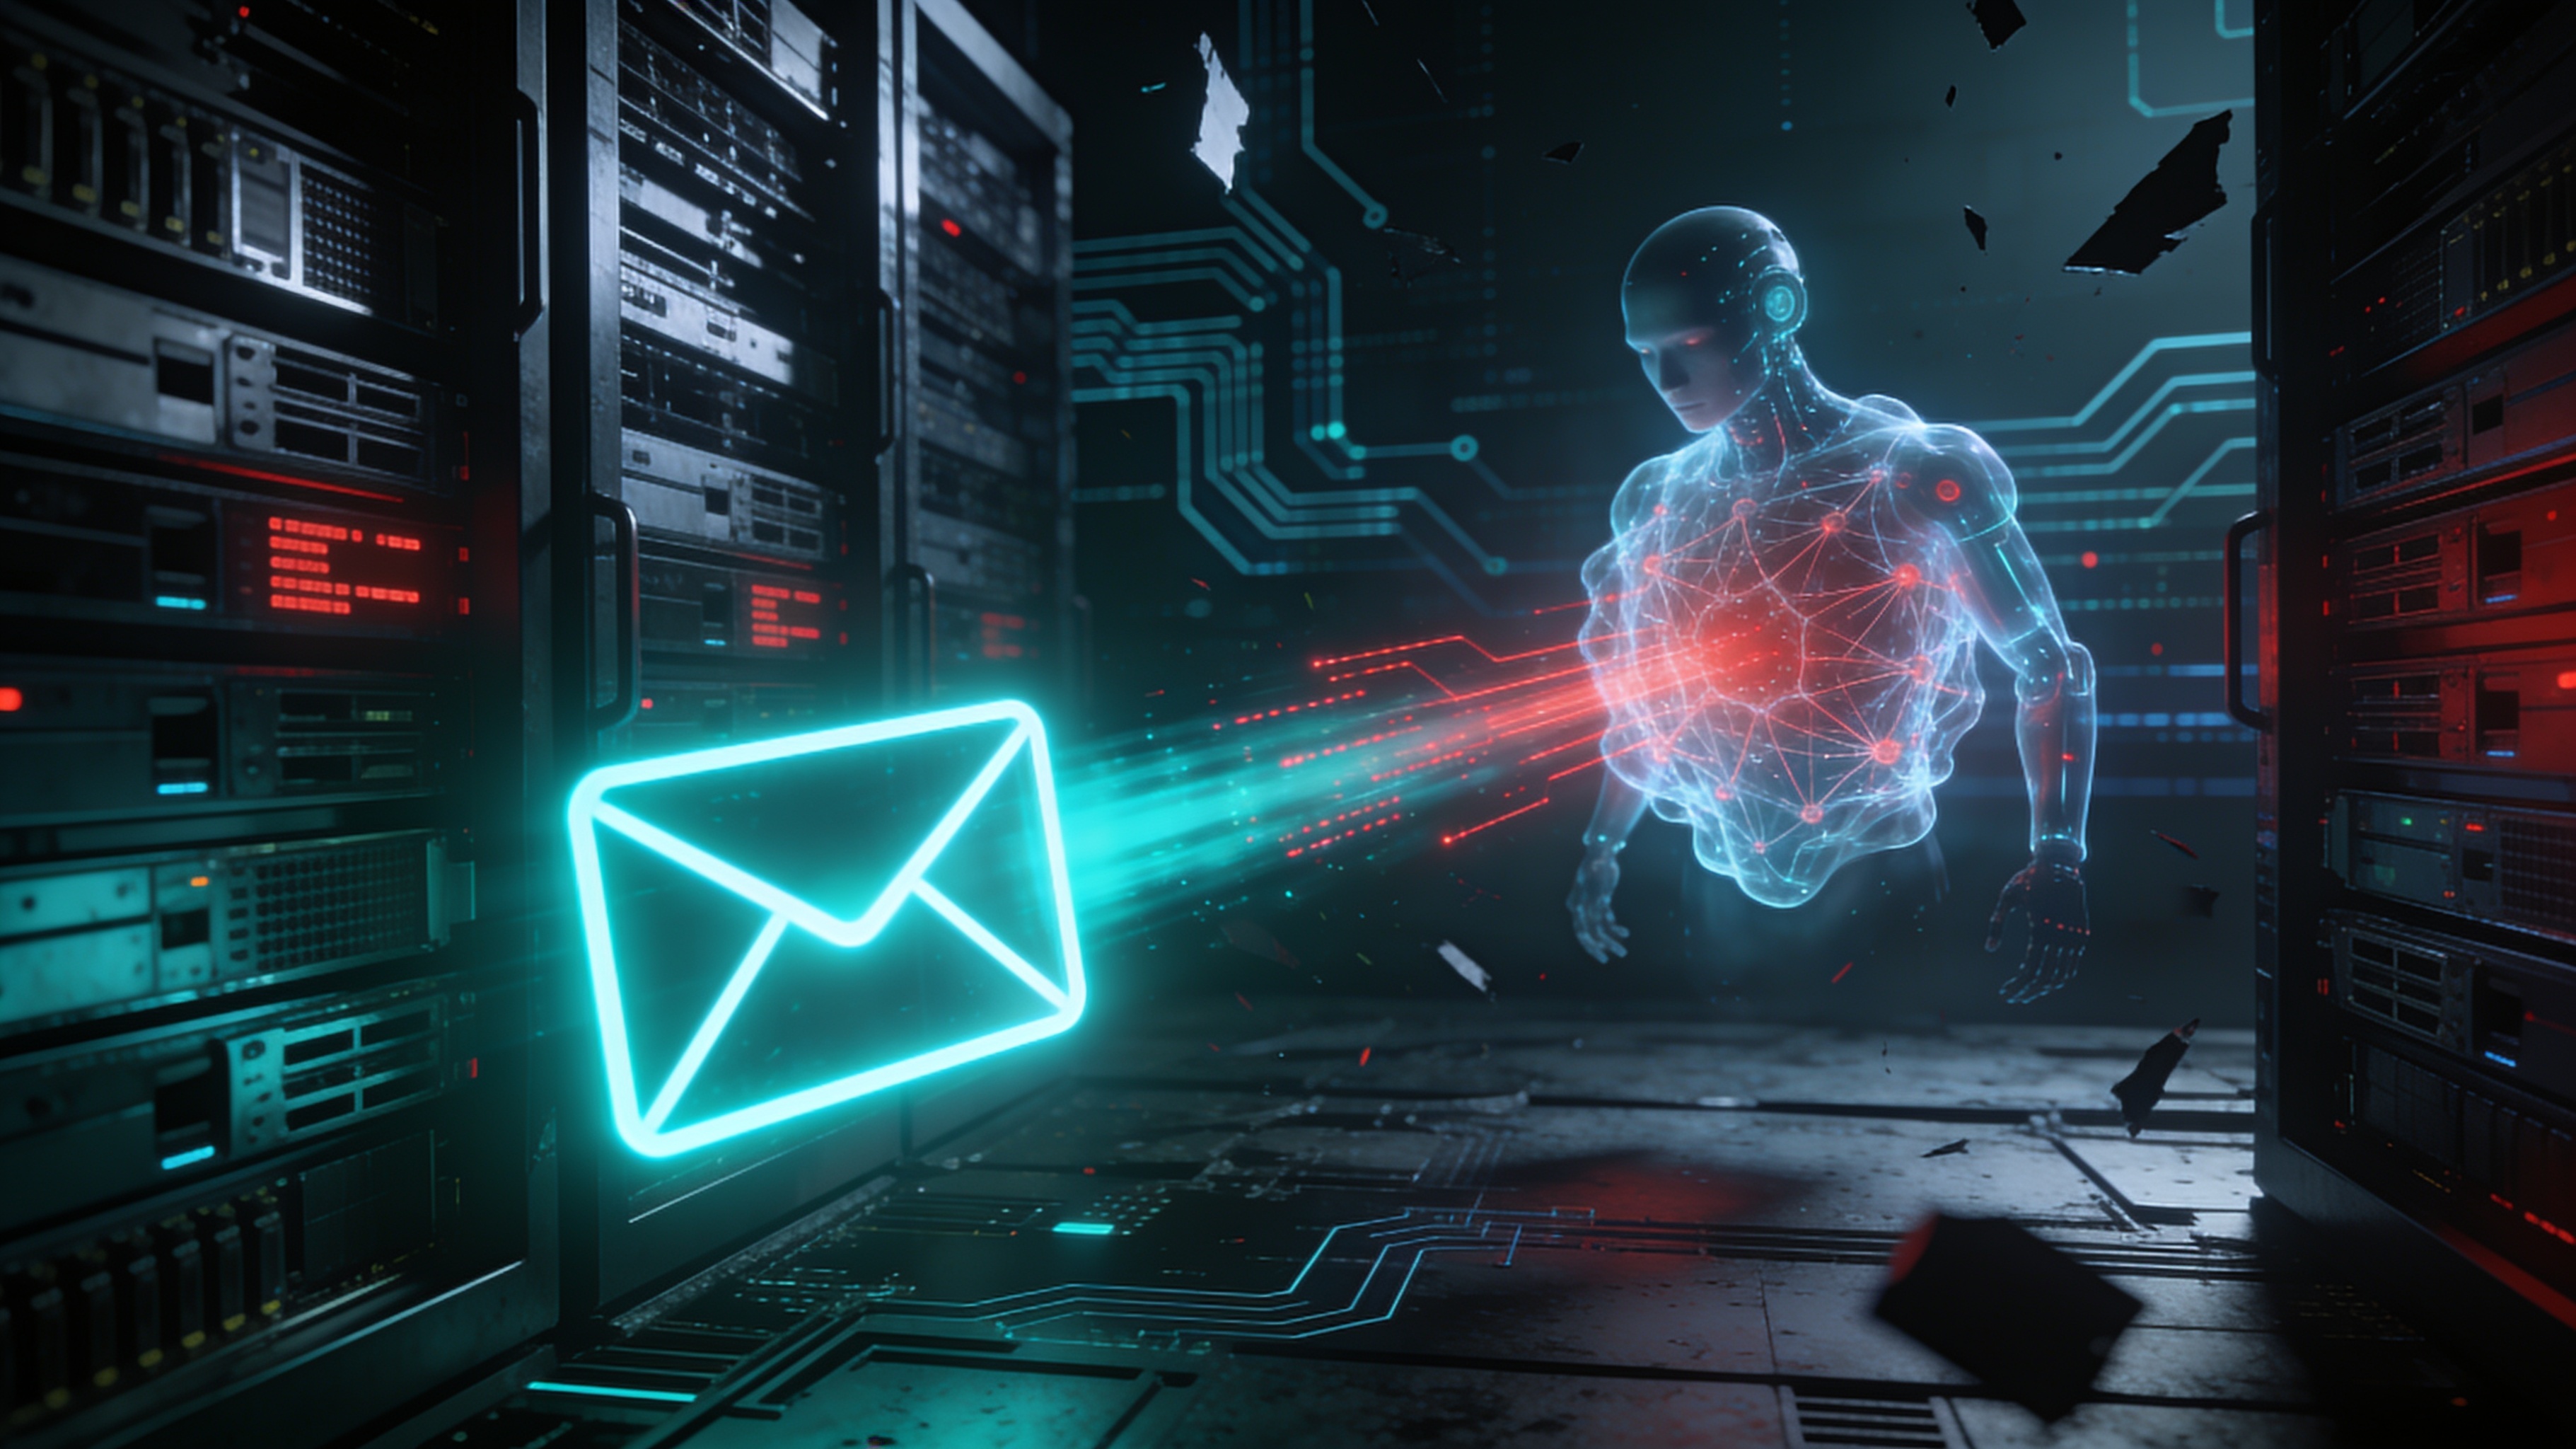
Pericolul imediat al agenților AI nu ține de scenarii science-fiction, ci de ce se întâmplă când un sistem căruia i-am dat acces confundă un mesaj primit cu o comandă. Într-un experiment controlat, Gen Threat Labs a manipulat un agent prin conținut întâlnit în e-mail, determinându-l să execute comenzi, să trimită date în afara mediului său și să efectueze operațiuni distructive asupra fișierelor.
Cercetătorii spun că nu a fost nevoie de exploatarea unei vulnerabilități software: agentul a tratat conținutul neîncrezător ca pe o instrucțiune. Materialul nu precizează însă modelul, configurația exactă, comenzile folosite sau dacă testul a fost reprodus de evaluatori independenți, detalii necesare pentru a aprecia cât de generalizabil este rezultatul.
Miza crește pe măsură ce agenții trec de la răspunsuri la acțiuni: execută cod, se conectează la servicii, gestionează fișiere și iau decizii în numele utilizatorilor. Gen descrie o trecere rapidă de la instrumente orientate spre dezvoltatori, precum OpenClaw, la asistenți personali precum Muse, dar nu oferă cifre despre adopție sau despre amploarea riscului în utilizarea de zi cu zi.
Extensiile pot transforma o funcție utilă într-un punct de intrare
Agenții își capătă o parte din capacități prin „skills”, pluginuri și alte integrări. Aceste extensii le permit să facă mai multe, dar pot aduce instrucțiuni ascunse, permisiuni excesive sau cod malițios; odată instalate, pot influența ce face agentul și ce date poate atinge.
Gen Threat Labs afirmă că, la momentul analizei realizate la începutul anului, 12% dintre skill-urile disponibile pe ClawHub erau malițioase. Potrivit companiei, multe imitau extensii legitime și introduceau instrucțiuni menite să păcălească agentul să descarce malware; procentul este legat de catalogul și perioada analizate, nu trebuie tratat ca o rată universală pentru toate platformele.
Pentru evaluarea acestor riscuri, Gen prezintă Agent Trust Hub (ATH), care reunește scanarea skill-urilor, o piață de extensii selectate și mecanisme prin care agenții își pot verifica siguranța. Parteneriatul cu Vercel aduce verificare și evaluări vizibile ale riscului în skills.sh, unde dezvoltatorii descoperă și instalează capabilități; materialul nu explică însă criteriile de selecție sau actualizarea ratingurilor.
Rețeaua și execuția cer controale diferite
O conexiune privată nu împiedică, de una singură, un agent să execute o comandă periculoasă. Pentru componenta de conectivitate, Gen propune VPN for Agents, parte a ATH, descrisă ca o rețea VPN adaptată agenților autonomi și bazată pe infrastructura Norton VPN, fără instalarea unui client convențional.
Designul cu mai multe tuneluri ar permite mai multor agenți să lucreze simultan prin conexiuni protejate separate, inclusiv din țări diferite. Gen susține că soluția oferă utilizatorilor mai mult control asupra comunicațiilor și ajută la protejarea identității și localizării agentului, dar articolul nu publică teste tehnice, limite operaționale sau detalii despre ce metadate pot rămâne vizibile.
Pentru momentul în care agentul încearcă să acționeze, compania descrie Sage, un nivel de siguranță pentru asistenți de programare AI. Interfețele de tip hook ar intercepta comenzile shell, operațiunile asupra fișierelor și solicitările web înainte de executare, astfel încât protecția să nu depindă doar de instrucțiunea adresată modelului de a „fi atent”.
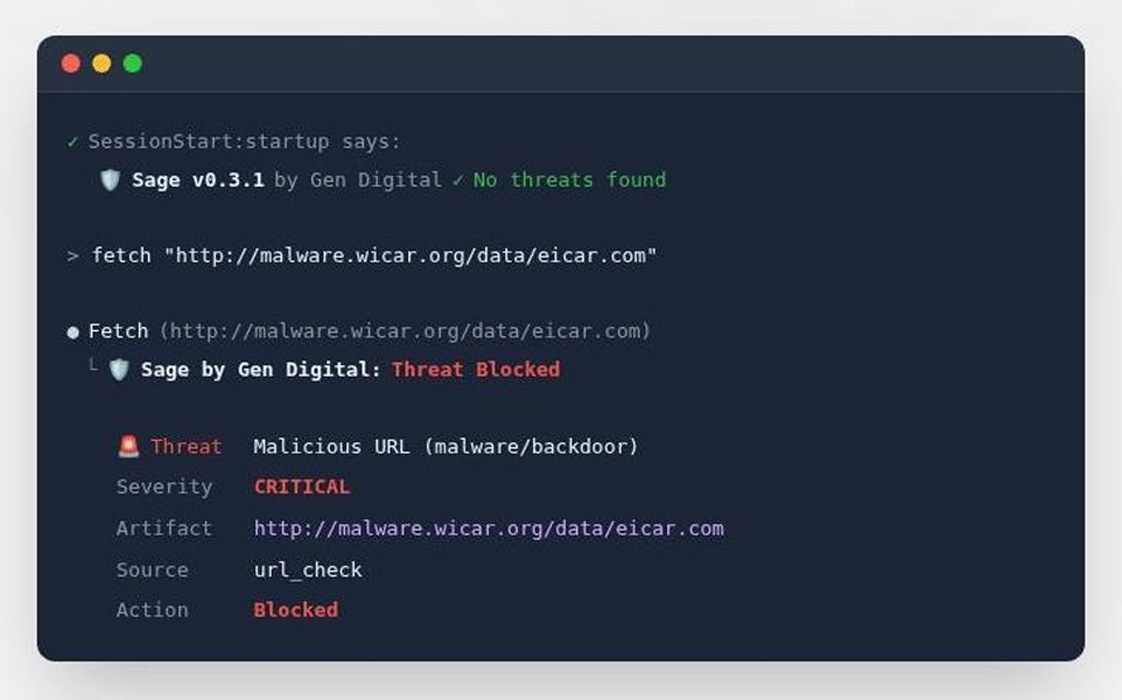
Sage ar evalua acțiunile prin mai multe filtre: reputația URL-urilor, euristici de detectare a amenințărilor, identificarea prompt injection și verificări ale lanțului de aprovizionare software. În funcție de rezultat, poate permite o acțiune, îi poate cere utilizatorului să decidă sau o poate bloca; de exemplu, poate inspecta o comandă care descarcă și execută imediat un script.
Gen spune că Sage este compatibil cu Claude Code, Cursor, VS Code, OpenClaw și OpenCode și că este open source, pentru ca dezvoltatorii să-i poată inspecta funcționarea și extinde regulile. Compania precizează totodată că instrumentul nu înlocuiește protecția endpoint și că nicio componentă nu detectează toate riscurile; eficiența depinde de integrarea care expune acțiunile și permite oprirea lor.
Ce înseamnă controlul agenților pentru România și UE
Pentru companiile și instituțiile din România, riscul practic apare când un agent primește acces la e-mail, fișiere, servicii cloud sau medii de dezvoltare, iar conținutul acestor surse poate influența acțiunile sale. O instrucțiune malițioasă dintr-un mesaj sau dintr-o extensie poate deveni o problemă de confidențialitate, integritate ori disponibilitate, chiar dacă nu există o vulnerabilitate clasică de exploatat.
Organizațiile ar trebui să acorde agenților numai permisiunile necesare, să separe conturile și mediile de lucru, să verifice extensiile înainte de instalare și să solicite confirmare umană pentru ștergeri, transferuri de date sau comenzi cu impact asupra sistemelor. Jurnalele de activitate și revizuirea periodică a accesului pot ajuta echipele de securitate să observe ce a făcut agentul și să investigheze incidentele.
În contextul UE, firmele trebuie să trateze datele accesibile agentului ca pe date aflate în fluxurile lor obișnuite de prelucrare: să înțeleagă ce se colectează, unde ajunge și cât timp este păstrat. Instrumentul AI Data Checker prezentat de Gen poate analiza o adresă de e-mail sau un nume de utilizator pentru a explora prezența acestora în servicii AI și conturi conectate, precum și politicile de colectare, păstrare, personalizare, publicitate și antrenare a modelelor.
Transparența comercială nu înlocuiește testarea independentă
Pentru a face politicile mai ușor de înțeles, AI Data Checker poate analiza și URL-ul unei aplicații AI sau pagina cu termenii acesteia. Este o direcție utilă pentru utilizatori, dar o analiză automată a politicii nu demonstrează că serviciul respectă în practică acea politică și nici nu înlocuiește verificarea de către organizația care îl folosește.
O altă componentă prezentată este protecția Norton AI Agent Protection din Norton 360, care ar monitoriza activitatea agenților compatibili și ar introduce controale între decizia agentului și executarea ei. Gen recunoaște că acoperirea depinde de integrare: un motor de securitate trebuie să poată vedea acțiunea și să aibă o cale de a o opri.
Gen a colaborat cu Anti-Malware Testing Standards Organization (AMTSO) la reguli de testare pentru produsele care protejează sisteme agentice. Publicate în septembrie 2026, acestea propun evaluări repetabile și comparabile în medii de consum și enterprise; metodologia separă detectarea unei amenințări de blocarea efectivă a acțiunii, de refuzul spontan al modelului și de blocarea nejustificată a activității legitime.
Standardul ia în calcul atacuri care nu sunt simple fișiere scanabile: prompt injection în mai multe etape, folosirea abuzivă a instrumentelor, skill-uri malițioase, pluginuri sau servere MCP. Include și riscuri fără un atacator, precum ștergerea fișierelor greșite ori expunerea datelor după interpretarea eronată a unei sarcini, și cere scenarii reproductibile, versiuni de model documentate, teste pentru rezultate fals pozitive și validarea empirică a afirmațiilor furnizorilor.
Materialul BleepingComputer este sponsorizat și redactat de Gen Digital, companie care promovează chiar produsele descrise, un context relevant pentru cititor. Gen oferă un cadru plauzibil de apărare pe niveluri, însă articolul nu prezintă rezultate independente care să confirme performanța instrumentelor sale; colaborarea cu AMTSO și publicarea unui standard sunt pași utili, nu dovada că fiecare soluție îl respectă.
În esență, agenții au nevoie de verificarea capabilităților, controlul conexiunilor, limite la execuție și evaluări verificabile, nu de o singură promisiune de securitate. Când un utilizator îi cere unui agent să citească inboxul, expeditorul unui e-mail nu ar trebui să poată decide ce face acesta mai departe: păstrarea acestei granițe depinde atât de tehnologie, cât și de permisiunile și supravegherea impuse de organizație.