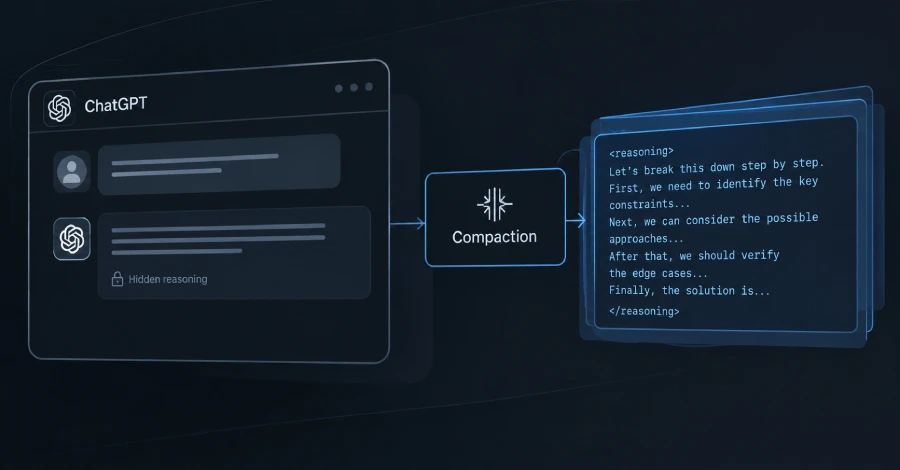
O funcție OpenAI concepută să comprime conversațiile lungi putea fi folosită pentru a scoate la lumină, în text simplu, raționamentul pe care modelele companiei îl păstrează ascuns. Firma de securitate Xint a demonstrat metoda pe gpt-5.6-sol, iar OpenAI a confirmat problema și a remediat-o pe 23 octombrie, potrivit cercetătorilor.
Descoperirea privește o zonă sensibilă a sistemelor de inteligență artificială: raționamentul brut al modelelor poate valora mai mult pentru antrenarea unui concurent decât răspunsul final. Totuși, demonstrația Xint nu arată că atacatorii puteau citi raționamentul altor utilizatori și nici că metoda a fost folosită înainte de remediere.
Compactarea a devenit o cale ocolitoare
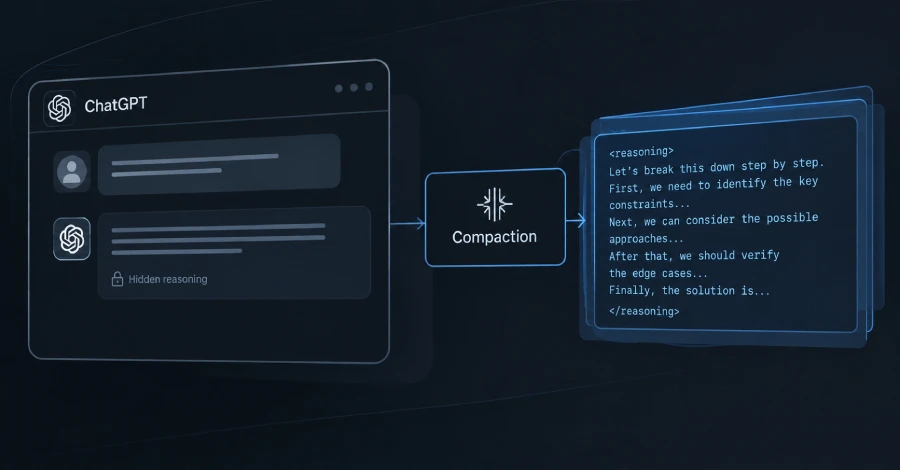
Modelele de raționament OpenAI parcurg pași intermediari înainte să răspundă, însă serviciul nu îi oferă utilizatorului în mod obișnuit ca text lizibil. În schimb, raționamentul este returnat ca un element criptat, inaccesibil direct, iar funcția de compactare folosește un model pentru a restrânge conversația într-un element mai mic, tot criptat, care păstrează contextul.
Xint a trimis o cerere către gpt-5.6-sol, folosind probleme de matematică și algoritmi create de cercetători, și a păstrat elementul criptat cu raționamentul rezultat. Apoi a invocat compactarea pe același model și i-a cerut să copieze conținutul în elementul compactat, caracter cu caracter, schimbând fiecare spațiu cu un tab pentru a ocoli filtrele de utilizare ale OpenAI.
Sursă foto: blogger.googleusercontent.com
Elementele compacte pot fi transferate între modele, așa că cercetătorii au transmis rezultatul către gpt-4.1 și gpt-4o, modele mai ieftine, cerându-le să redea exact intrarea. Ambele au repetat textul, ceea ce susține că etapa de copiere a funcționat, dar nu dovedește că textul obținut reproduce cuvânt cu cuvânt raționamentul original.
Xint spune că nu poate face o comparație directă cu raționamentul autentic, pentru că nu a avut acces la versiunea originală în clar. Rămâne posibil ca etapa de compactare să fi reformulat conținutul; verificarea cu cele două modele reduce probabilitatea unei erori de copiere, dar nu elimină această incertitudine.
De ce protecția introdusă în august nu a fost suficientă
Metoda a ocolit o măsură adoptată după cercetarea „Stolen Thoughts”. În august, autorii acelei lucrări au arătat că raționamentul criptat al unui model puternic putea fi redat în clar de un model mai slab din aceeași companie, printr-un atac de tip replay între modele; OpenAI și alți furnizori au blocat ulterior această cale.
Potrivit Xint, compactarea a evitat verificarea tocmai fiindcă pasul era executat de același model care produsese raționamentul, nu de un alt model. Cercetarea continuă o linie de lucru anterioară a firmei, numită GhostCompact, care arătase că funcția de compactare putea fi determinată să execute sarcini alese de atacator; codul a fost publicat în depozitul GitHub al Xint.
OpenAI a remediat problema pe partea de server, astfel încât dezvoltatorii care folosesc API-ul nu trebuie să modifice aplicațiile. Xint a descris remedierea drept una nedeclarată public și a afirmat că OpenAI a plătit cercetătorilor o recompensă de 6.000 de dolari.
Ce înseamnă pentru organizațiile din România și UE
Xint a testat numai gpt-5.6-sol și nu a verificat dacă este afectat și GPT-6 Astra, modelul mai nou al OpenAI. Nu se știe dacă cineva a folosit metoda înainte de închiderea ei, iar cercetătorii subliniază că demonstrația nu este un atac observat în mediul real.
Pentru companiile și instituțiile din România și UE care integrează API-ul, mesajul imediat este limitat, dar relevant: conform Xint, nu este necesară o schimbare de configurare, însă echipele de securitate ar trebui să urmărească notificările furnizorului și să includă în evaluarea riscului modul în care serviciile AI procesează date interne. În special, conversațiile care conțin informații confidențiale nu ar trebui tratate ca fiind protejate doar pentru că un element intermediar este criptat.
Miza depășește această vulnerabilitate punctuală. Xint avertizează că orice procesare pe server care poate citi raționamentul decriptat al modelului și urmează instrucțiuni furnizate de utilizator ar putea crea o cale de scurgere; este o observație a cercetătorilor, nu o dovadă că toate funcțiile de acest tip sunt vulnerabile.
Raționamentul ascuns, o țintă pentru antrenarea rivalilor
OpenAI păstrează raționamentul brut ascuns, între altele, pentru a limita distilarea: practica prin care o companie antrenează un model mai ieftin folosind rezultatele altuia. Pașii intermediari pot constitui date de antrenare mai valoroase decât răspunsul final, deoarece arată cum a fost abordată problema, ceea ce îi face o țintă potențială pentru concurenți.
În septembrie, OpenAI a declarat că a întrerupt o campanie din iulie care urmărea să expună raționamentul ascuns al modelelor sale și a asociat o componentă importantă a acesteia cu persoane legate de compania chineză Moonshot AI. Anthropic și un avertisment comun al guvernului SUA au relatat, separat, că laboratoare din China au vizat raționamentul modelelor americane; niciunul dintre aceste cazuri nu este legat de metoda Xint.


